Содержание
Мониторинг и логирование нужны, чтобы узнавать о сбоях раньше пользователей и быстро находить причину. Минимальный набор для веб-проекта — проверка доступности снаружи, сбор ошибок приложения, метрики сервера и базы данных, структурированные логи и несколько алертов на действительно важные события.
Разберём, из чего состоит наблюдаемость, какие сигналы собирать, как настроить оповещения без шума и с чего начать небольшой команде.
Что такое наблюдаемость?
Наблюдаемость — это способность понять, что происходит внутри системы, по данным, которые она отдаёт наружу. Её строят на трёх типах сигналов: метриках, логах и трассировках. Вместе они отвечают на вопросы «что сломалось», «где» и «почему».
| Сигнал | Что показывает | Пример |
|---|---|---|
| Метрики | Числа во времени: нагрузка, ошибки, задержки | 2% ответов с кодом 500 за последние 5 минут |
| Логи | Отдельные события с подробностями | Ошибка оплаты заказа 1842: таймаут банка |
| Трассировки | Путь одного запроса через все сервисы | Запрос к API ждал 3 секунды ответа от базы |
Какие метрики собирать в первую очередь?
В первую очередь собирайте метрики, которые напрямую отражают опыт пользователя: долю ошибок, время ответа и количество запросов. Для этого есть простое правило «четырёх золотых сигналов».
- задержка — сколько времени занимает ответ, лучше в перцентилях p95 и p99, а не в среднем;
- трафик — сколько запросов приходит в секунду;
- ошибки — доля неуспешных ответов;
- насыщение — насколько загружены процессор, память, диск и соединения с базой.
Отдельно стоит следить за бизнес-метриками: количеством заказов, регистраций и успешных оплат. Если они резко упали, а технические графики зелёные, — проблема всё равно есть.
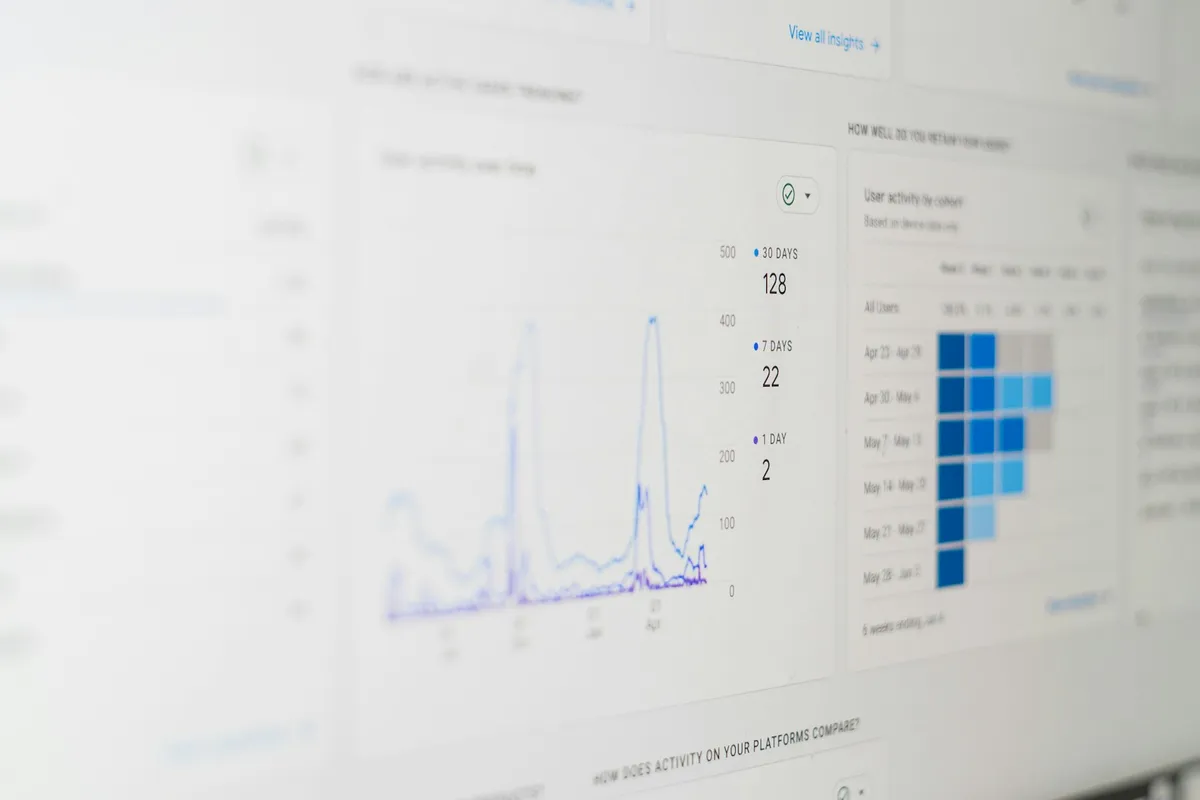 Фото: Unsplash
Как правильно писать логи?
Логи стоит писать в структурированном виде — JSON с одинаковыми полями, — чтобы их можно было искать и фильтровать, а не читать глазами. В каждой записи нужен идентификатор запроса: по нему собираются все события одного обращения пользователя.
{
  "level": "error",
  "message": "Payment failed",
  "request_id": "9f2c1a",
  "order_id": 1842,
  "provider": "bank",
  "duration_ms": 30012
}
Правила для логов
- Используйте уровни:
debug— для разработки,info— для важных событий,error— для того, что требует внимания. - Не пишите в логи пароли, токены и полные данные карт; персональные данные маскируйте.
- Собирайте логи всех серверов в одно место, а не храните их на каждой машине.
- Ограничьте срок хранения, иначе логи станут самой дорогой частью инфраструктуры.
Как защищать персональные данные, мы разбирали в статье персональные данные на сайте.
Как настроить алерты, чтобы не утонуть в уведомлениях?
Алерты настраивают на симптомы, которые замечает пользователь, а не на каждую техническую причину. Если оповещение приходит, а реагировать на него не нужно, — его надо убрать или превратить в отчёт, иначе команда привыкнет игнорировать все уведомления.
Хорошие алерты:
- срабатывают на рост ошибок или задержек дольше нескольких минут, а не на единичный всплеск;
- содержат ссылку на график и короткую инструкцию, что проверить;
- делятся по срочности: критичные — в мессенджер дежурному, остальные — в общий канал;
- регулярно пересматриваются: лишние удаляются, пропущенные инциденты превращаются в новые правила.
С чего начать небольшой команде?
Небольшой команде достаточно начать с готовых сервисов и закрыть четыре вещи: внешнюю проверку доступности, сбор ошибок приложения, метрики сервера и централизованные логи. Это настраивается за один-два дня и не требует отдельного специалиста.
Порядок действий:
- Подключите внешнюю проверку главной страницы и API раз в минуту.
- Добавьте сервис сбора ошибок — он покажет исключения с контекстом и количеством пострадавших пользователей.
- Соберите метрики сервера, базы данных и очередей на одном дашборде.
- Отправляйте логи в одно хранилище с поиском.
- Настройте три-пять алертов на ключевые сценарии: оплату, авторизацию, оформление заказа.
Когда проект вырастет, к этому добавляются трассировки и единый стандарт OpenTelemetry. О том, как выпускать изменения без простоя, — в статье релизы без простоя, а о стоимости сопровождения — в материале сколько стоит поддержка сайта и приложения.
Коротко
- Наблюдаемость строится на метриках, логах и трассировках.
- Главные метрики — задержка, трафик, ошибки и насыщение, плюс бизнес-показатели.
- Логи пишите в JSON с идентификатором запроса и без секретов.
- Алерты — только на то, что требует реакции, иначе их перестанут читать.
- Начните с проверки доступности, сбора ошибок, дашборда и централизованных логов.
Частые вопросы
Чем мониторинг отличается от наблюдаемости?
Мониторинг отвечает на заранее известные вопросы: работает ли сервис, не выросли ли ошибки. Наблюдаемость позволяет разобраться и в новых, непредвиденных проблемах — за счёт связанных между собой метрик, логов и трассировок.
Сколько хранить логи?
Обычно подробные логи хранят 7–30 дней, а агрегированные метрики — месяцы. Для аудита и требований закона отдельные события хранят дольше, но персональные данные в логах лучше маскировать.
Нужен ли мониторинг маленькому проекту?
Да, но в минимальном объёме: проверка доступности, сбор ошибок и базовые метрики сервера. Это настраивается за день и окупается при первом же сбое.